
Hunderte echte Gespräche. Gleichzeitig.
Voice-to-Voice-Interviews, die so präzise nachfragen wie eine erfahrene Moderatorin - in jeder Sprache, in jeder Größenordnung, mit jedem Befund bis zum O-Ton zurückverfolgbar.
Du fragst. Sie sprechen. Es hört zu. Echte Nachfragen statt starrem Skript - damit die interessante Antwort nicht verloren geht.
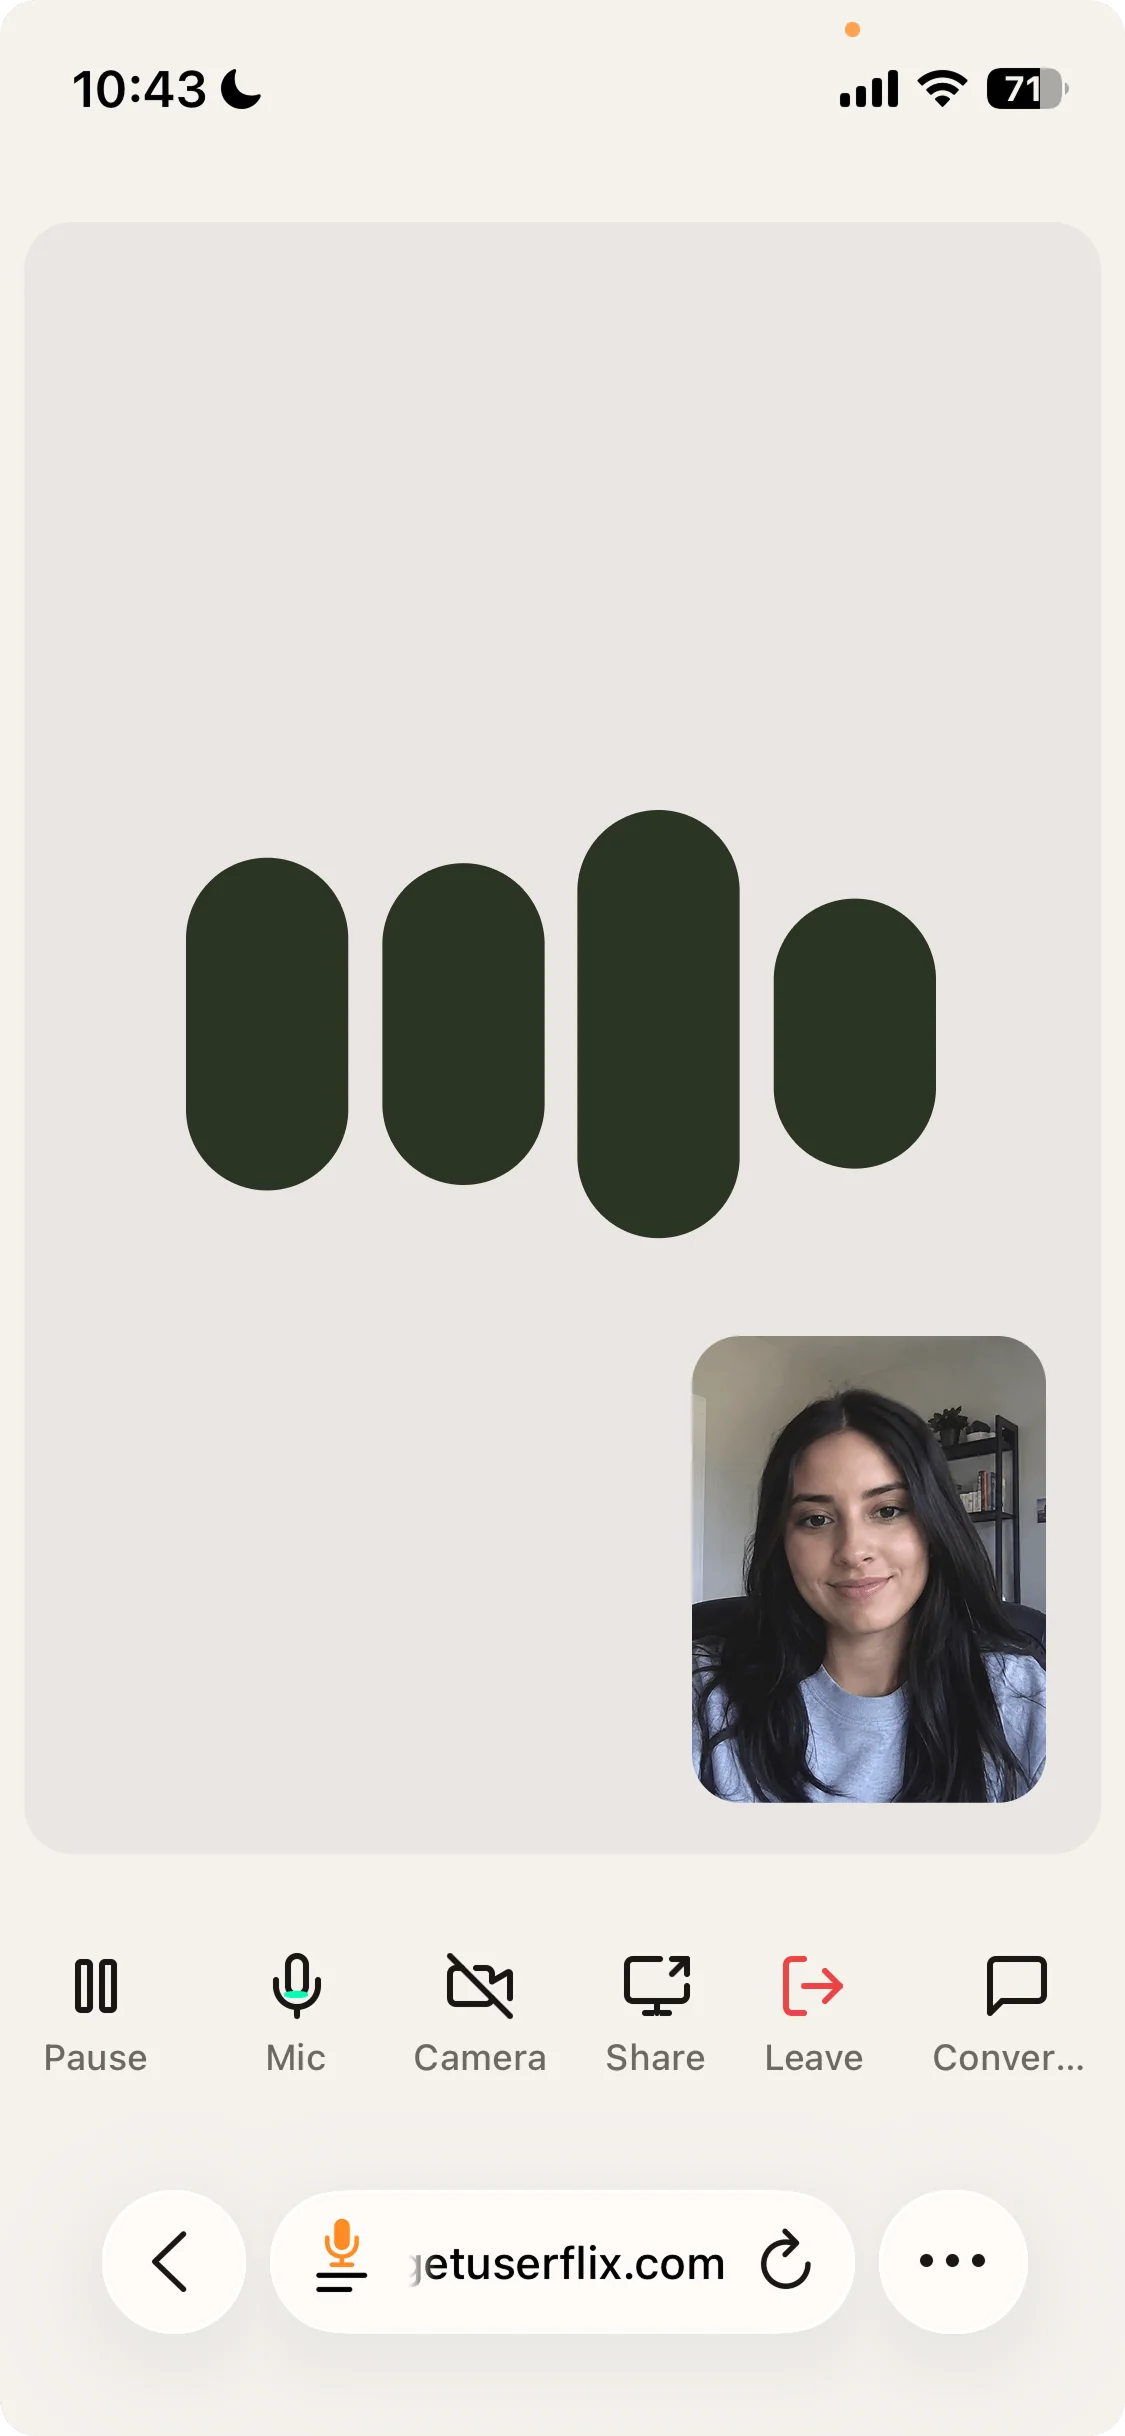
So vertraut wie ein Videoanruf.
Teilnehmende erhalten einen Link, treten der Session bei und sprechen ganz natürlich. Keine App, kein Account, keine Terminabsprache.
- 01
Link erhalten
Per Umfrage, E-Mail oder Panel. Öffnet sich in jedem Browser - kein Download nötig.
- 02
Natürlich sprechen
Der Moderator begrüßt sie und passt sich dem Gesagten an - genau wie ein echtes Gespräch.
- 03
Du bekommst die Insights
Transkript, Analyse und ein nachvollziehbarer Bericht landen automatisch in deinem Dashboard.
Der Dialog, nicht das Skript.
Jedes Interview läuft Voice-to-Voice, mit adaptiven Nachfragen statt starrem Fragebogen. Es verfolgt die interessante Antwort - das, was eine Umfrage niemals leisten kann.
- Dynamische Nachfragen, keine feste Verzweigungslogik
- Über 50 Sprachen, nativ gesprochen
- Entwickelt, um Suggestivfragen und Verzerrungen zu minimieren
Qualitative Tiefe. Quantitative Reichweite.
Hunderte Interviews parallel - und jede Zahl im Bericht lässt sich auf eine echte Stimme zurückverfolgen.
- 01
Hunderte, gleichzeitig
Offene Nachfragen über die gesamte Stichprobe hinweg - parallel. Kein Moderatorenengpass.
- 02
Bis zum O-Ton nachverfolgbar
Codierte Auszählungen, keine Schätzungen. Jeder Befund führt zurück auf den Moment, in dem er geäußert wurde.
- 03
Bericht in Tagen, nicht Wochen
Transkription, Analyse und ein präsentationsreifer Bericht - aktualisiert, sobald Interviews eingehen.
“Es hat mir zurückgespiegelt, was ich gesagt hatte, sodass ich mich gehört fühlte - so wie sich ein echtes Gespräch mit einem anderen Menschen anfühlt.”
Bildschirm teilen. Sehen, was sie sehen.
Teilnehmende teilen eine Website, einen Prototyp oder eine Produktseite im Voice-Interview. Die Moderation sieht denselben Bildschirm, beobachtet die Interaktion und Userflix fragt zu Pausen, Klicks und Scrollen nach.
- Websites, Figma-Prototypen, Produktseiten und Anzeigen per Bildschirmfreigabe
- Klicks, Scrolls und Zögern sind für die Moderation sichtbar
- Stimme, Kamera und geteilter Bildschirm bleiben in einer Oberfläche
- Nachfragen beziehen sich auf das, was auf dem Bildschirm passiert ist
Sollen Teilnehmende ihren physischen Kontext zeigen - ein Regal, einen Kühlschrank, ein Produkt im Einsatz? Das können Messaging-Interviews

Die Tiefe einer Moderatorin. Ohne die Obergrenze.
vs. Fokusgruppen
Kein Gruppendenken, keine dominanten Stimmen, keine sechs Termine für einen Raum koordinieren.
Vergleichvs. Klassische Einzelinterviews
Dieselbe Eins-zu-eins-Tiefe - in einer Größenordnung, die kein Mensch als Moderatorin erreichen könnte.
Vergleichvs. Synthetische Befragte
Echte Menschen, echte Stimmen. Keine simulierten Personas, die Antworten erfinden.
VergleichHäufige Fragen

Das Warum hinter jedem Was.
Sieh dir ein echtes Voice-to-Voice-Interview von Anfang bis Ende an.